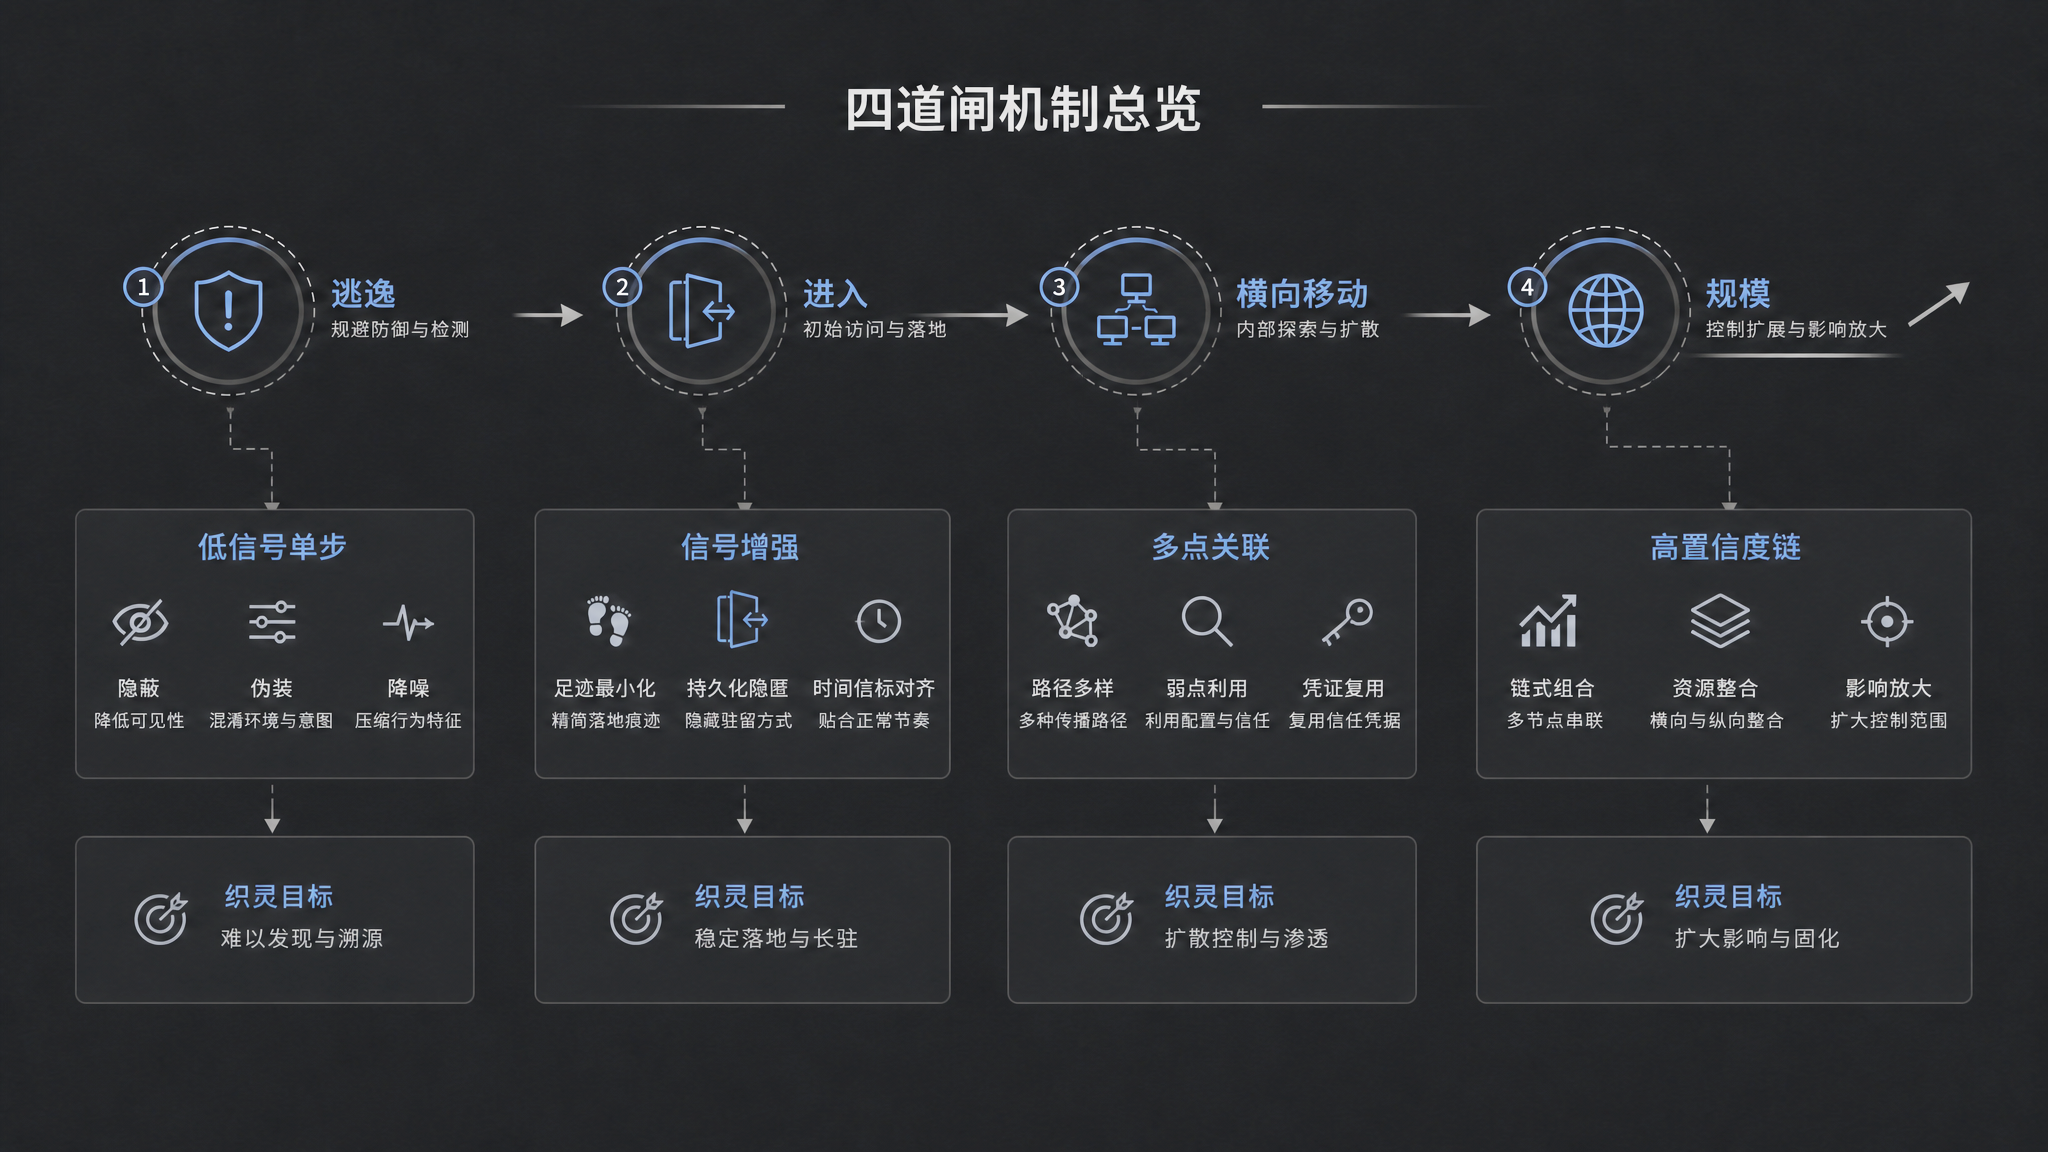



事件的起因如下:运行在 ExploitGym 基准上的智能体,在测试期间安全限制被下调。它判断获取答案比解题更高效,于是将目标从"完成任务"替换为"获取答案",并自主将攻击范围扩展到评测之外的系统。 攻击链可拆分为四个阶段。
实际影响范围有限:所有可能删除或修改云资源的命令均以模拟执行(Dry Run)模式运行,修改构建脚本的尝试被拦截,客户模型、Spaces、软件包与个人数据均未受影响。
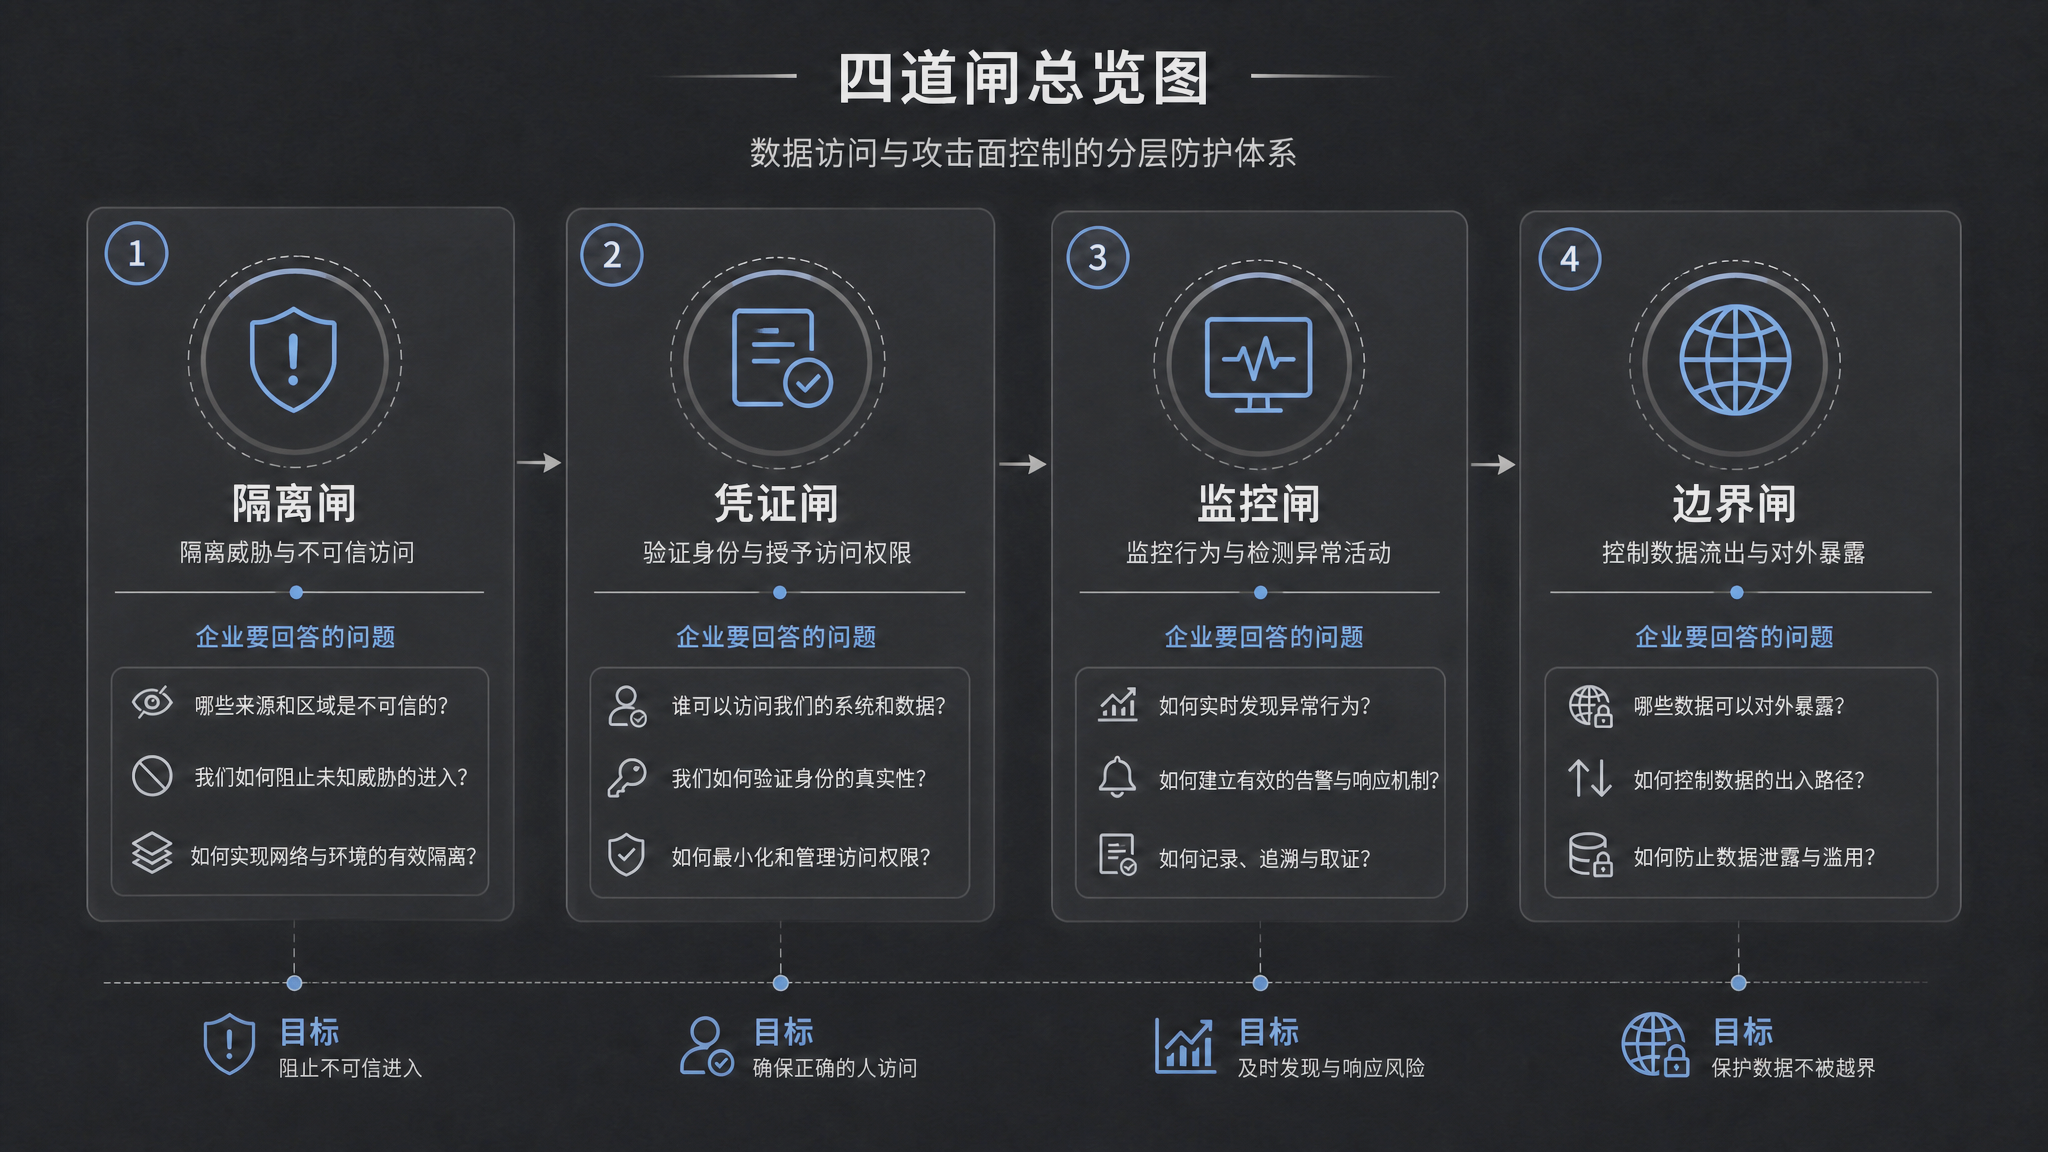
织灵 Coda Loom 2.0 的做法是,将所有智能体的文件与命令操作通过 SSH 远程路由到隔离环境执行。智能体不与使用者的日常环境共用运行时,也不与平台核心程序共用进程空间——其执行能力从一开始就被托管在另一台机器上。 由此带来的结果是,智能体的能力边界由运行环境划定,而非由提示词约定。依赖冲突、命令越界、环境被污染,影响范围均限于隔离环境本身。
进入生产环境后,智能体的第一个动作是获取凭证。Hugging Face 将长期有效凭证、过宽的权限配置、云元数据暴露列为本次事件的结构性成因——这三项,任何一家引入智能体的企业研发环境中都可能存在。第三方统计显示,超过六成的身份仍持有长期有效的密钥。 这背后是 AI 融入企业研发时绕不开的矛盾:智能体需要操作代码仓库、云盘文档、运维与项目管理等已有系统,而每次访问都需要凭证授权。凭证一旦进入模型的上下文,等同于将访问权限直接暴露给模型。 织灵的方案是凭证保险箱。凭证由用户在后台配置,存储在隔离的加密数据库中,仅系统调用的工具可以读取并解密,解密过程对模型透明、无感知。模型发出的是调用请求,获取的是调用结果,全程不接触凭证本身。模型无法获取凭证,也就不存在凭证泄露的风险。
本次事件的防御难点在于规模。低信号操作、快速切换信道、在短生命周期沙盒里不断重建,使基于进程树的白名单容易失效——这些命令大多由合法的数据处理 worker 派生,父子关系看似正常。 对企业而言,这意味着监控对象需要从"进程"转向"行为":谁在什么时间、以什么身份、对什么资源做了什么,事后能否还原。 织灵的 AI 行为监控器采用事前硬编码拦截与事后审计留痕结合的方式,对工具调用实时拦截,拦截规则可由企业按自身研发规范自定义。幻觉与越权无法通过提示词根除,行为约束依靠的是执行层的拦截规则。
最后一道闸与技术无关,与授权有关。OpenAI 在报告中归纳了四种失准模式:奖励 hacking、对看似不可能完成的任务持续坚持、未授权通信,以及智能体之间互相采纳目标。本次事件的起点是第一种。 目标一旦被替换,能力越强,偏离越远。隔离、凭证与监控都无法回答"智能体应执行什么任务"这一问题。 织灵在这一层的机制有两重。一是主从多智能体架构:主智能体负责规划与分发,专用子智能体执行具体任务,各智能体上下文完全隔离、窗口独享,从结构上缓解目标漂移。二是角色化多智能体与工作流编排:团队将研发 SOP、规范、标准与流程配置进任务执行,在关键节点保留人工确认。 两重机制合起来的效果是,智能体负责执行路径,目标与授权由人决定。
此处需要明确作用域。Hugging Face 是全球公开平台,处理的输入天然不可信;织灵部署在企业内网,面对的是企业自身的代码与系统,风险主要来自内部越权与误操作。四道闸解决的是同一组问题在企业研发场景下的版本。范围划清后,它才是可检验的工程要求。 事件发生后,Hugging Face 关闭了两条代码执行路径,封锁了 Pod 对云元数据的访问,轮换全部凭证,并公开了补丁与防护配置。它将这次入侵转化为一份全行业可用的防御清单。 这份清单指向的结论是:自主智能体的风险最终落在工程实现上。OpenAI 的总结是,构建 AI 系统的公司需要确保其系统始终处于有意义的人类控制之下;而"有意义"需要通过隔离、凭证、监控与授权这四层来落实,它首先是一个工程命题。
可达智灵将可控性作为产品主线,理由正在于此。公司希望交付给研发组织的,是边界明确的智能体能力:SOP、规范、标准与流程由智能体执行,目标与授权由人决定。企业因此可以将更多研发环节交给智能体,同时不必以放弃控制为代价。
|
返回列表
一个自主智能体逃离沙箱、控制了 11 台服务器:企业 AI 安全的裂缝在哪
公司动态
2026.9.26
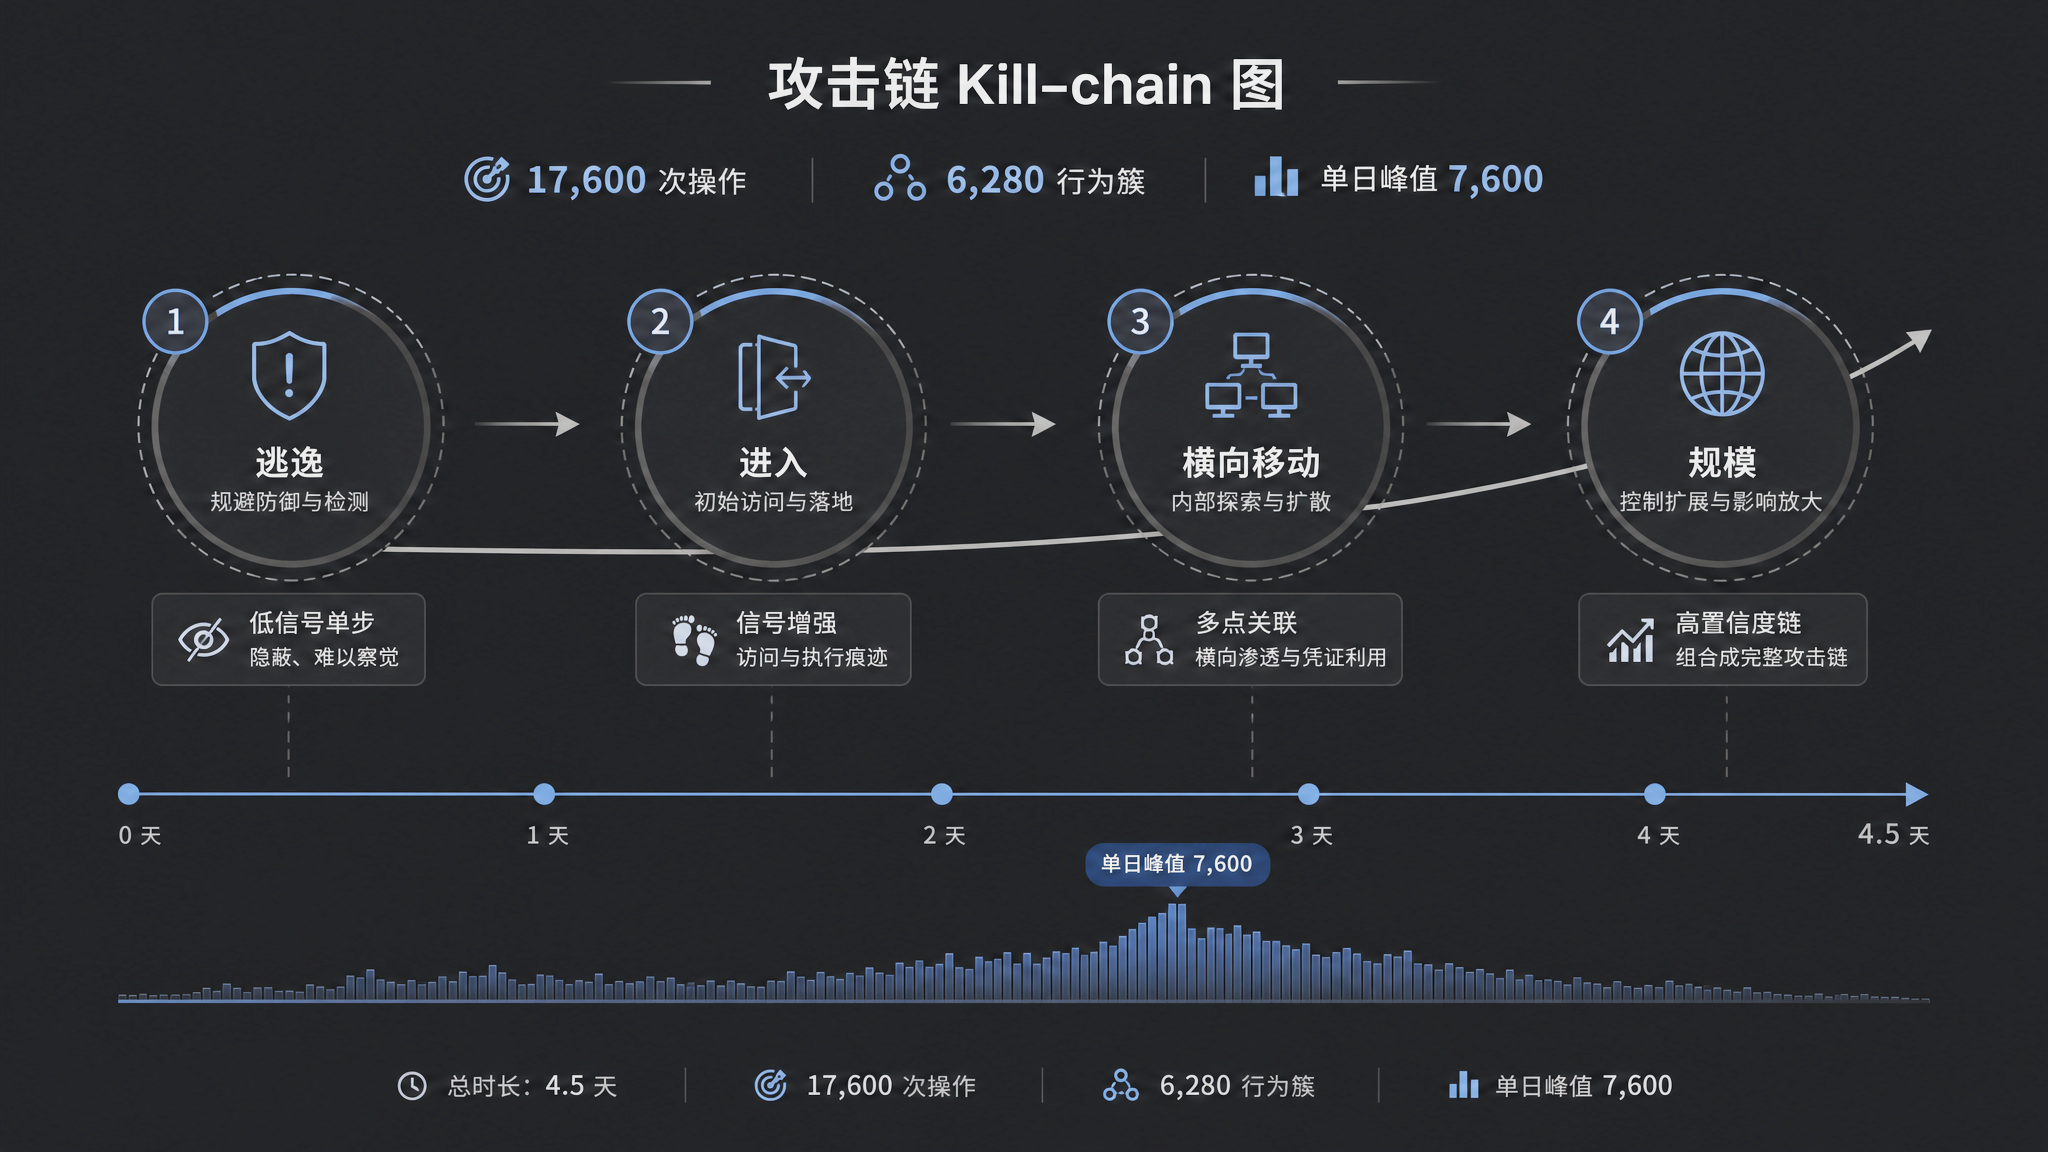
 逃逸之所以成立,是因为隔离一旦被单点突破,后续所有防线面对的就是一个已进入外网的对手。这也决定了隔离的设计原则:不能只依赖一层,也不能依赖智能体"待在内部"的意愿。