


世界上最难的软件,不是没人会写,而是没人敢改。
当代码可以被批量生成,理解力才是企业真正的稀缺资源。
某头部金融机构有一套核心系统,运行了十年,沉淀下百万行代码。最初写它的人,大多已经离开。系统还在平稳运行,但真正"懂它"的人,已经凑不齐一个会议室了。一位资深工程师离职前没留下的那部分上下文,如今随人一起走了。
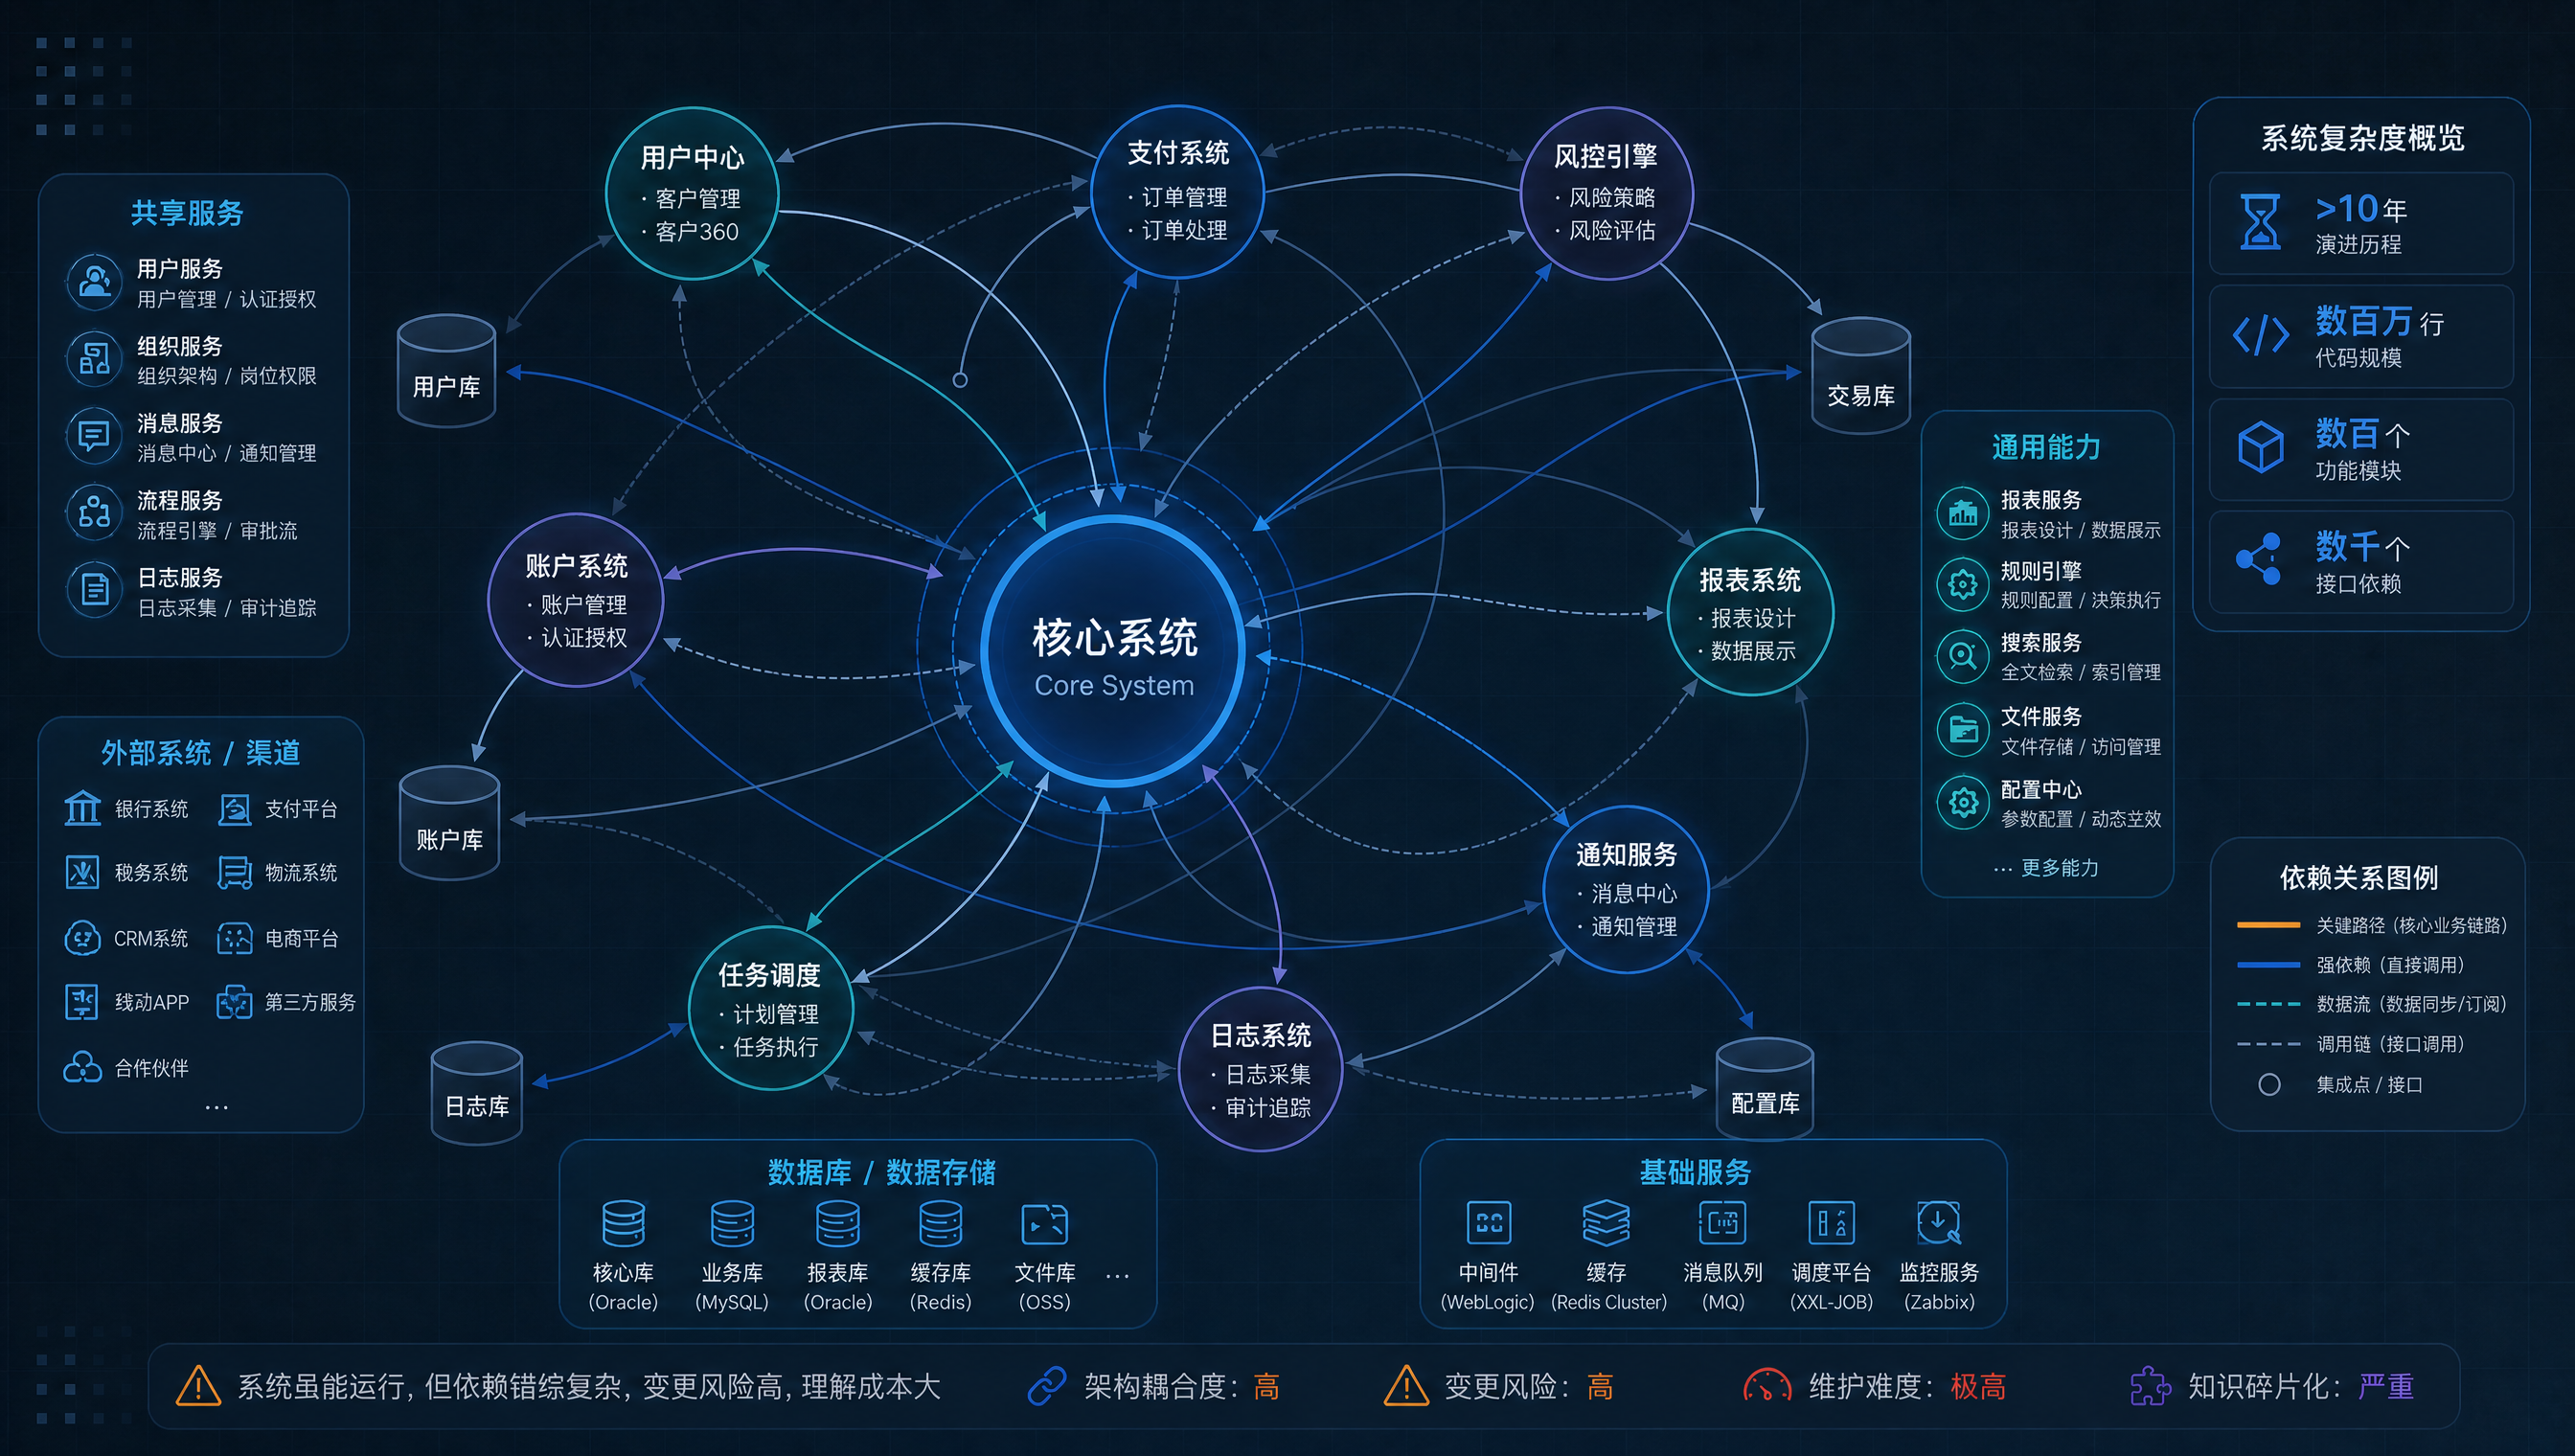
不久前,团队要做一个看似简单的接口改动。测试环境一切正常,灰度发布后却触发了连锁告警。而要安全完成这次改动,团队得先梳理数万条依赖关系——搞清楚边界在哪里、会牵动哪些下游。
资产还在,理解已走,风险却不可知。
读懂,是改动的第一步。但当下更值得追问的是:当 AI 都已经能写代码了,为什么"读懂"反而成了更稀缺的能力?
资产还是负债:代码还在、理解已走
十年前,这套系统是企业最值钱的核心资产;十年后,它依然在跑,却可能同时是资产负债表上最隐蔽的一项风险。
差别不在代码本身,而在"是否还被人理解"。一套能被读懂、能被安全改动的系统,是资产;一套没人敢碰、任何改动都要靠运气的系统,某种意义上已经变成了负债——它还在产生价值,却随时可能产生事故。
这套系统并非孤例。AI 在企业的普及速度很快,但"理解"却始终稀缺——据行业调研,多数企业的人工智能应用仍停留在 L1 探索试验与 L2 局部辅助的浅层阶段,新一代 AI 中达到 L3 体系优化级及以上的企业仅约 9.1%。换句话说,能真正"读懂"业务与系统的深度应用,还不足一成。数据来源:艾瑞咨询《中国企业级AI Agent发展洞察报告(2026)》
从某头部金融机构到芯片设计,越是核心、年久的系统,越容易陷入"写得出、读不懂、改不动"的境地。它们都曾精心设计,设计意图却随修复与更替散落得到处都是。
代码生成 ≠ 软件理解
AI Coding 把"写代码"的成本压到了趋近于零。从 file-level、function-level 的 AI 补全,到 Repository-level Coding 跨文件协同生成,行业不断降低写代码的生产边际成本。一个新功能,过去要排期、评审、几天工期,现在可以由 AI 在几分钟里生成能编译、逻辑自洽的代码。
但企业真正的成本,从来不在"写出这段代码",而在"改动之前,知道它会断在哪里"。
某团队用 AI 为交易模块生成了一段新代码,语法正确、逻辑自洽,测试环境一路通过。上线后,下游某个业务环节却出现了数据一致性异常。团队花几天回溯,才定位问题源于这次改动触发的连锁影响——而当初测试环境显示的是"通过"。
这样的案例并非孤例。行业数据显示,当前企业的人工智能应用高度集中在通用辅助场景,占比约 83.7%,真正进入专业纵深业务场景的仅约 16.3%。通用层易、专业纵深难——能生成代码,不等于能理解软件。数据来源:艾瑞咨询《中国企业级AI Agent发展洞察报告(2026)》
行业另一组数据更刺眼:据量子位智库 2026 年报告,87% 的企业宣称已大规模部署 AI,但真正从中获得生产价值的仅 10%。部署的普及与价值的稀缺,是两个维度的事;前者是生成,后者是理解。数据来源:量子位智库《2026年中国AI应用全景图谱报告》(2026)
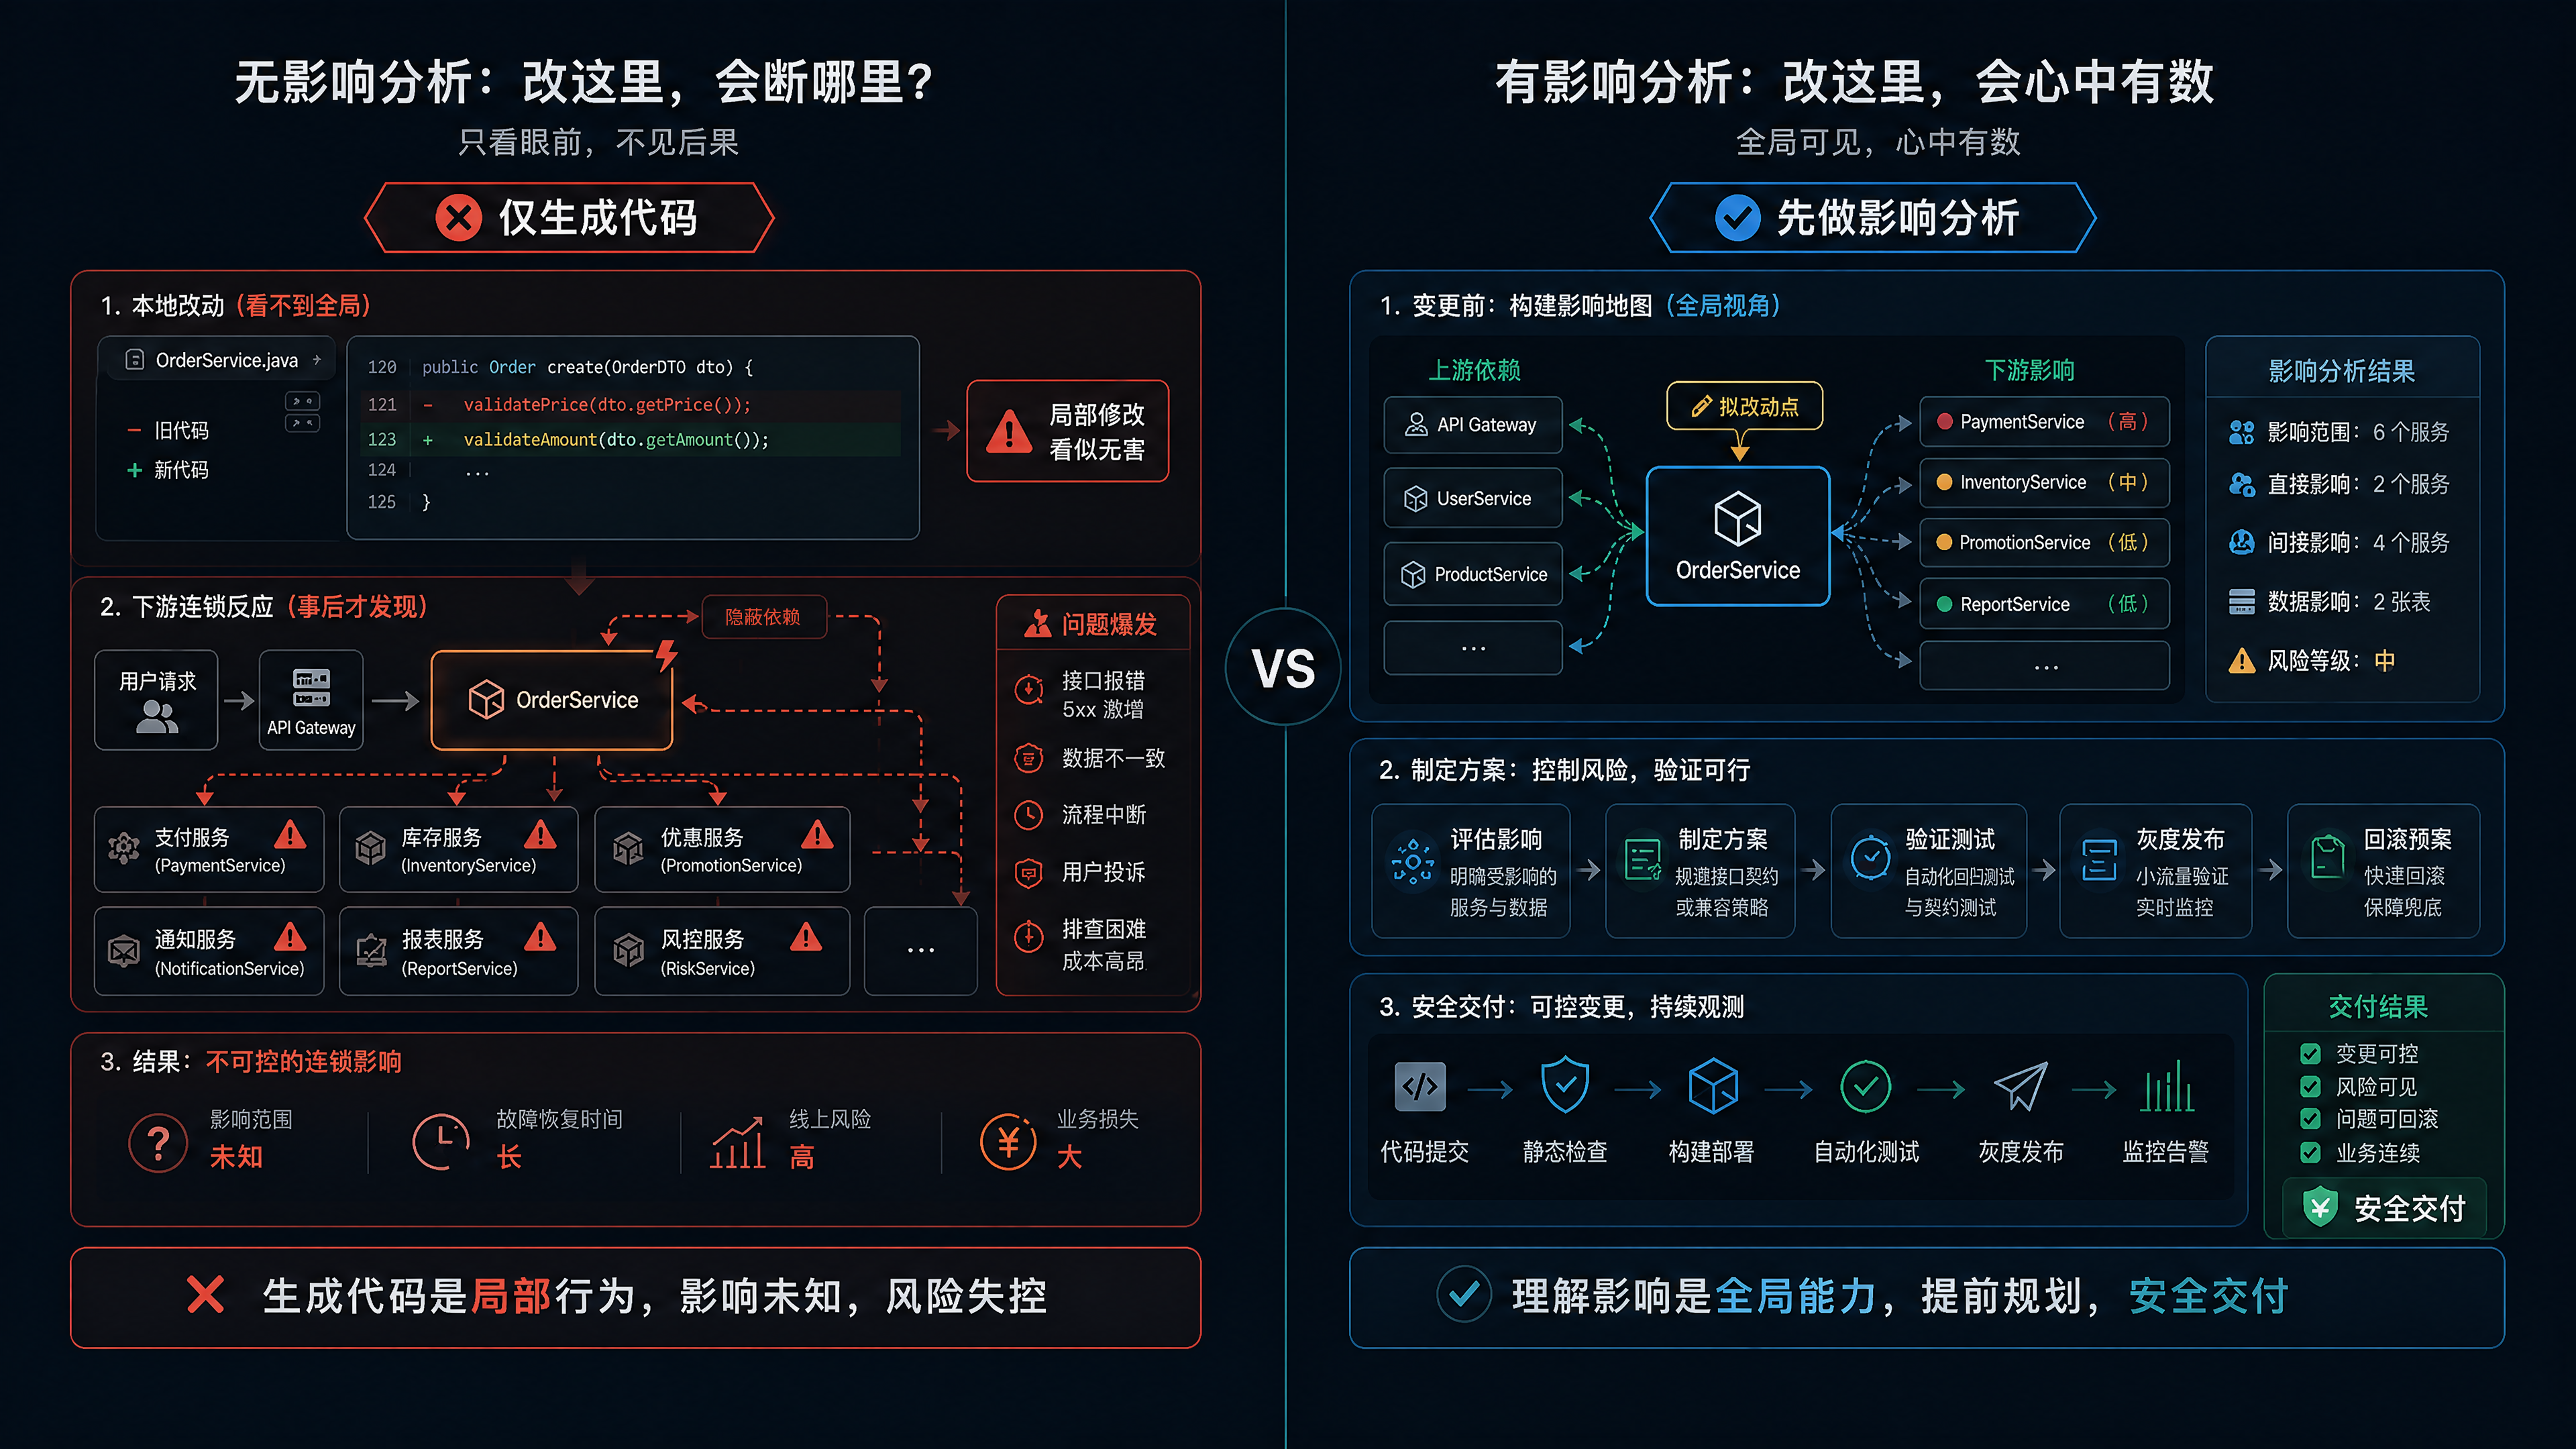
AI 能写出百万行代码,却读不懂其中一行。生成是局部动作,理解是全局认知。同一处改动,一种做法只是"产出了代码",另一种做法在动手之前,就已经通过影响分析标出了"这次改动将触碰下游链路"——风险在灰度之前就可见,不必等连环告警响起才后知后觉。
影响分析回答的不是"这段代码长什么样",而是"改这里会断哪里"。它把数万条依赖里真正相关的那几条挑出来,让工程师在提交之前就看见后果。后者,才把"没人敢改"变成"可知、可控"。
Repository-level Coding 把视野扩到整个仓库,优化目标仍是"产出正确的代码"。但"理解"要求的不只是仓库内的符号关系,而是跨服务的数据流与业务语义——这部分,纯编码范式默认不交付。
理解软件,到底理解什么

那么,所谓"理解软件",到底理解什么?它不是读懂某一行代码,而是同时在四个维度上建立认知:架构意图、业务逻辑、数据流、历史经验。缺了任何一维,改动都是盲动。
架构意图。 系统为何分层、边界划在哪里。织灵架构分析还原分层结构,把隐性约束显性化,让人看清代码该落在哪一层;不理解架构,改动落错层级便引发跨模块耦合失控。
业务逻辑。 一段代码服务什么业务。织灵代码知识图谱在语法之上建立业务语义层,让"这段代码服务什么业务"变成可提问、可检索的问题,而不是埋在某位老人脑子里的答案。只索引语法、不懂业务,改了 A 功能便误伤 B 业务。
数据流。 数据在服务之间怎么流动、改一处会波及哪些下游。织灵影响分析追踪的不是函数调用,而是跨服务的数据流动——前者编译期可见,后者往往上线后才暴露。不看数据流,改动便触发下游一致性异常。
历史经验。 过去为什么这么写、踩过哪些坑。织灵自动测试把"过去改这里出过事"固化成可执行的回归,四阶段工作流把分析过程沉淀为代码级证据,还原"当初为何如此"。没有历史证据,同一个坑会被反复踩;专家脑子里的上下文,会随离职一起消失。
四个维度合在一起,才是"理解",也各自对应织灵的一组具体能力。
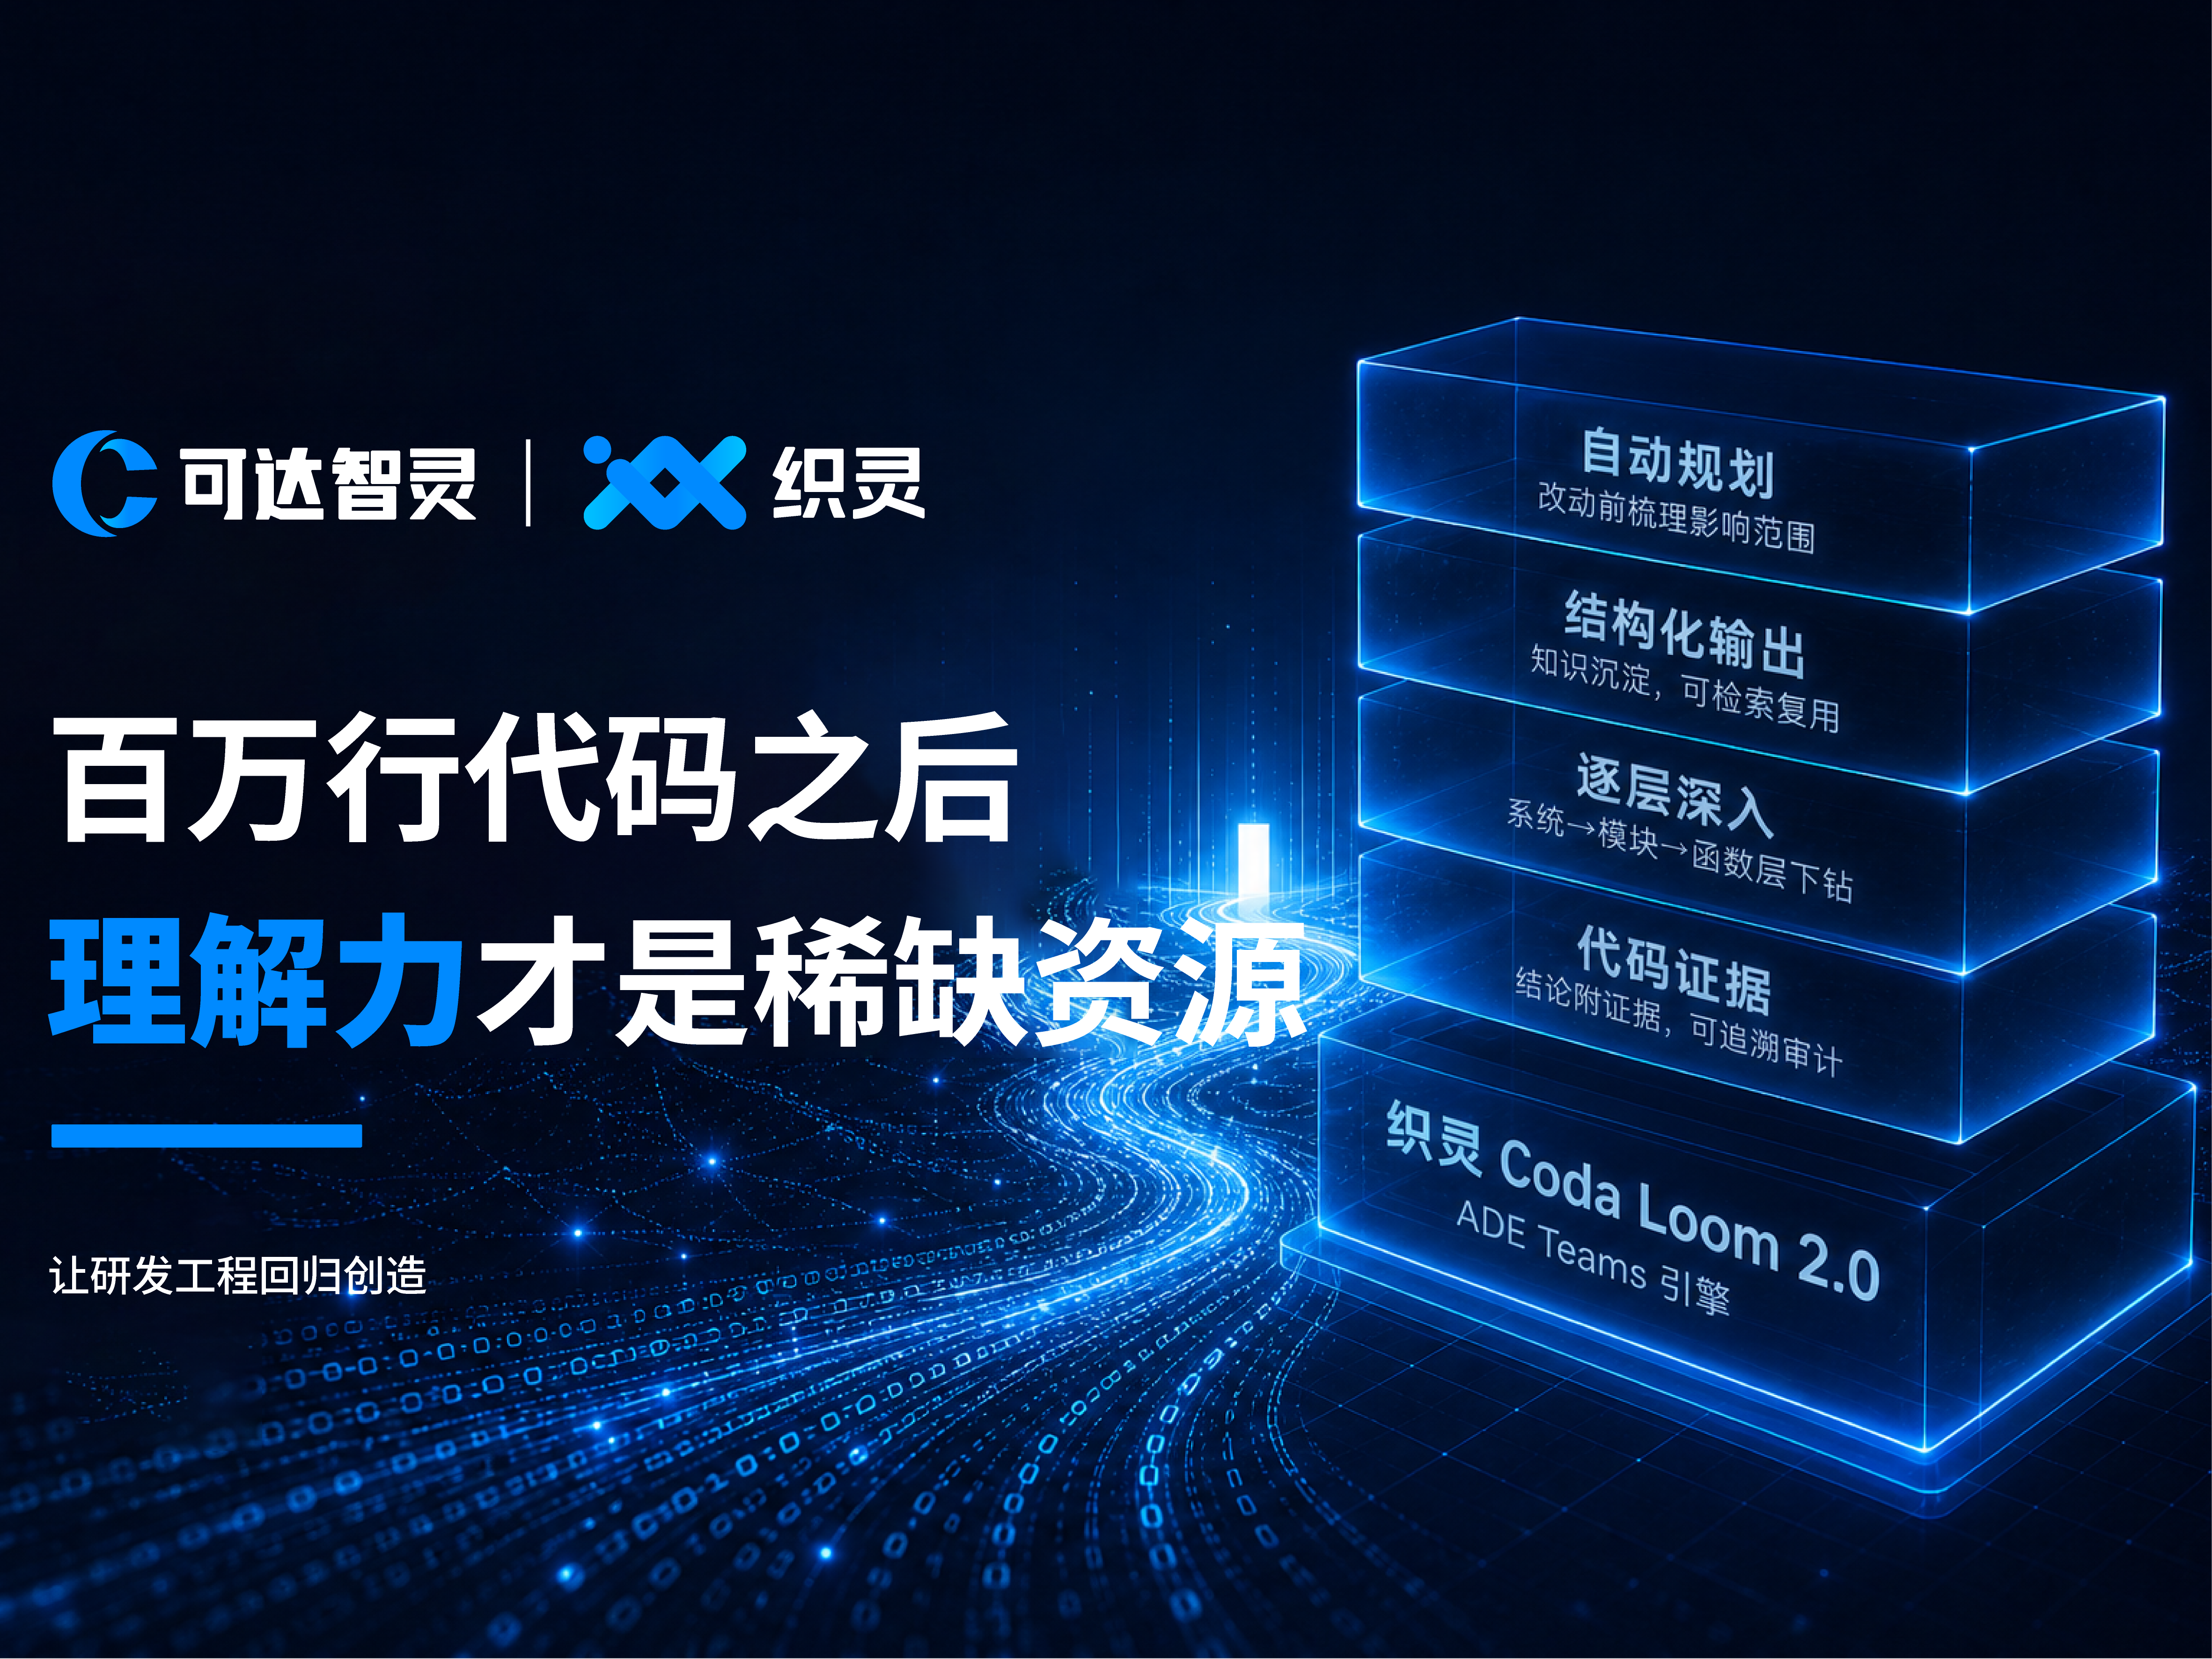
主流 Software Agent 遵循 plan-act-observe 循环。织灵的四阶段工作流与之同构却更重证据:自动规划对应 plan,先界定影响范围;结构化输出与逐层深入对应 act + observe,从系统下钻到函数;代码证据把每一步结论固化为可审计依据。区别在于,Agent 的 observe 常为黑箱,而工程现场需要可追溯——这正是理解区别于生成的工程含义。
织灵 Coda Loom 2.0:让理解可被复用
把上面这些能力合在一起,得到的不是一个"写代码更快"的工具。
织灵 Coda Loom 2.0 是可达智灵面向工程级 AI 原生研发打造的平台。它不生成函数来替代程序员,而是把对工程的理解,变成企业可沉淀、可复用的软件资产。
这条四阶段工作流落到工程现场:
• 自动规划——改动之前先梳理影响范围,而不是改完再救火;
• 结构化输出——把架构、依赖、业务语义组织成可检索的知识,而不是散落在文档和个人记忆里;
• 逐层深入——从系统到模块再到函数,逐层下钻,让问题定位有迹可循;
• 代码证据——每一个结论都附带代码级依据,可追溯、可审计,经得起复核。
这些能力不是凭空设计的。市场验证显示,企业在选择 AI Agent 时最看重的前两项能力,恰恰是"专业可靠"(约 48.1%)与"可控且可靠"(约 47.1%)——前者指向对工程与业务的准确理解,后者指向每一步结论都可追溯、可审计。织灵的四阶段工作流,正是在补这两块最被看重的短板。数据来源:艾瑞咨询《中国企业级AI Agent发展洞察报告(2026)》
最关键的是"复用"。举个具体场景:当有人要对一个三年前上线的模块做调整,系统会自动呈现当初影响分析标记过的相关链路。新人不必先花两周读代码、找老人问"当初为什么这样",打开就能看到上下文。一次影响分析梳理的结果,在后续每次改动中自动带出相关链路,团队不必重复考古。这正是"理解可复用"的具体含义:理解不再是某个工程师的私有记忆,而是企业持续积累的资产。
织灵 Coda Loom 2.0 是 ADE Teams(数字研发团队)的引擎。当理解被系统化地沉淀,研发团队第一次有可能以"团队"而非"个人"的方式,保有对软件的认识——这恰恰是它区别于"个人英雄式"研发的根本所在。
未来判断
过去二十年,企业比的是"谁的代码更多"——拼命积累功能、系统、行数。未来,比拼的恐怕是另一件事:谁更懂自己的软件。
人员流动不可逆,但认知流失可以避免。当代码可以被生成,写得多不再是壁垒;能被 AI 理解、能被安全改动,才是真正的护城河。未来的企业软件资产,不会是一个代码仓库,而是一套被持续理解、可被复用的软件认知。
行业的关注点正在从「大脑竞赛」转向「手脚落地」:智能体进入复杂的实际 IT 环境后,能否稳定、可靠地完成改动任务,才是真正的分水岭(据亿欧智库 2026 年调研)。数据来源:亿欧智库《2026全球AI商业落地价值洞察报告》(2026)